给 Agent 接公共记忆:先管住写入,再谈越用越好
以 hindsight 设计一套跨 harness 的公共经验记忆,说明记忆如何进入上下文、哪些规则不能交给它,以及从实验到接入的阶段门禁
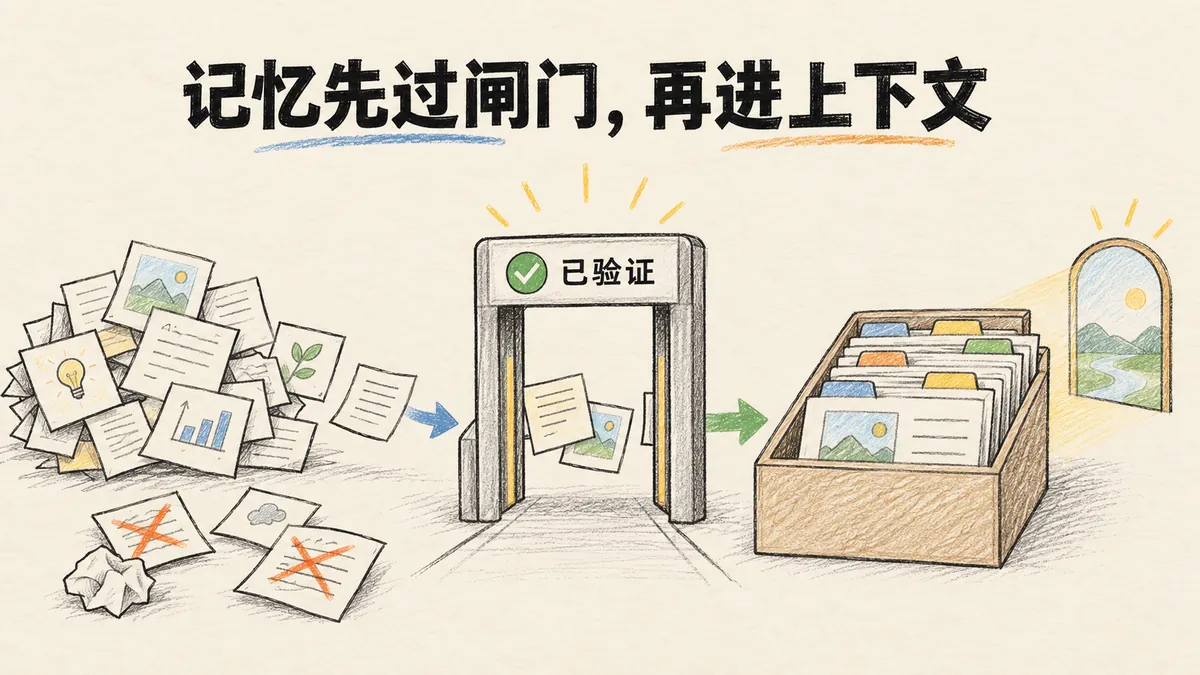
假设我昨天在 Claude Code 里纠正过一个判断:旧方案已经被新证据推翻。今天换到 Codex,它却拿着另一份记忆继续推荐旧方案。如果把两边的对话都自动汇总进公共库,问题也未必消失——旧结论可能反而传播到更多会话。
我想解决的是跨工具的经验复用,但公共记忆也会扩大错误的传播面。这里的 harness 指承载 Agent 的运行工具,例如 Claude Code、Codex 和 Pi。
公共记忆的价值不在于存得更多,而在于把有来源的经验送进上下文,同时把判断规则留在 Git 里。
我选择用 hindsight 验证这条路径。它是可自托管的记忆系统,写入时会用 LLM 加工材料,检索时再召回相关记忆。截至 2026-09-28,方案尚未开工,阶段 0 仍在等待部署主机连通;下文是设计与实验计划,没有效果数据。
先分清三层:框架、输入和结果
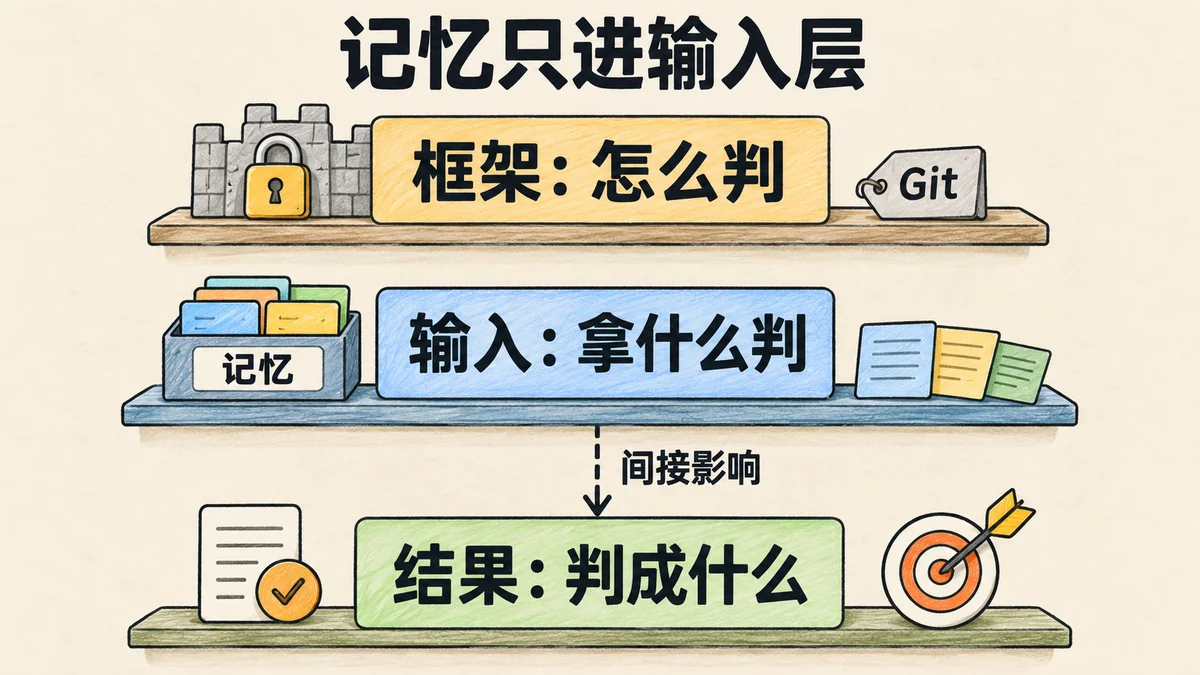
我不把记忆库当成另一个“会替我做决定的 Agent”。在一次任务里,至少有三层东西:
| 层次 | 它回答什么 | 权威放在哪里 | 公共记忆能做什么 |
|---|---|---|---|
| 框架 | 应该怎样判断? | baseline、skill、Git | 不碰 |
| 输入 | 判断要用哪些事实和先例? | 来源文件、决策记录、被纠正过的经验 | 负责召回 |
| 结果 | 这次判成什么? | 当次输出 | 不直接生成 |
这个边界决定了接入方式:hindsight 只负责把相关经验放进上下文,调用方决定要放多少;它不能修改判断优先级、红线或任务分级。
为什么不用“整段对话自动入库”
最省事的接法,是安装官方 Coding Agents 包,让每段会话自动 retain。这个方案没有采用,原因很直接:对话里混着未验证的猜测、临时指令、凭据痕迹和已经被推翻的结论。自动入库会把“说过”误当成“值得复用”。
写入入口改成显式闸门:只有带来源的已验证事实才能进入记忆。每条事实至少要有三项:内容、来源位置、原文引句。这样做牺牲了一点自动化,却保留了回溯和删除的可能。
reflect 会根据记忆生成答案,这里不用于决策类问题。我只取回记忆,由当前 Agent 按既有规则判断。
hindsight 内部的三处判断,分别设防
hindsight 并不是没有判断。它至少会在三个环节使用模型或排序算法,因此需要逐处设护栏:
| 环节 | 它会做什么 | 方案里的约束 |
|---|---|---|
| retain(写入加工) | 抽取事实、实体和时间 | 只送入带来源的已验证事实,抽取结果可以回看原文 |
| consolidation(合并) | 从多条事实形成派生观察,记录冲突 | 派生观察须保留引句,重要结论回原文核对 |
| recall(检索) | 多路召回、融合和重排 | 设最低分,低于阈值就返回空,不强行注入 |
“返回空”指不提供记忆,不是终止当前任务。Agent 仍可依据现有材料工作;材料不足时才应明确无法回答。Recall API 文档 特别提醒:分数不是跨问题校准的置信度,固定阈值可能漏掉正确结果。阶段 0 必须先看实际分布,再校准 reranker 或 final 下限;不能把“设了最低分”当成安全证明。
目标落层:替换存储,不替换领域规则
目标架构把 hindsight 放在基础设施层。领域层只定义记忆接口,具体实现可以换成 hindsight,也可以换回 Markdown grep;skill 和领域规则不应因此改写。
一次任务的目标路径是:问题进入 → 按项目选 bank → 召回并筛选 → 注入上下文 → 当前 Agent 判断;收尾时再核验事实、脱敏并写入。
记忆接口草图:把存储实现留在基础设施层
1
2
3
4
5
6
7
8
9
10
11
export interface MemoryPort {
  recall(query: string, opts?: { minScore?: number }): Promise<Recalled[]>;
  ingest(fact: VerifiedFact): Promise<void>;
}

export interface VerifiedFact {
  text: string;
  source: string;
  quote: string;
  context: 'personal' | 'team';
}
这里只展示读写契约,不是 hindsight SDK 的直接用法。Recalled 表示接入层的召回结果类型。minScore 是接口草图的命名,不是原生 API 字段;映射到 recall 的 min_scores 等参数仍需实现和测试。
bank 是一组记忆的存储空间;调用方不任意选择它,由边界切面根据项目上下文路由到个人或团队 bank。切面是任务前后统一执行的逻辑:入口选 bank、写前脱敏、提问时召回、收尾时核验写入。这层尚未完成,是日常接入的前置条件;bank 分开也不自动等于权限隔离,仍需独立验证访问权限。
接管哪些内容,留下哪些权威源
公共记忆的第一批对象是经验和索引,不是规则文件:
| 处理 | 对象 | 原因 |
|---|---|---|
| 替换 | Claude Code memory、Codex 原生 memories | 改为按相关度召回,避免每次整份加载 |
| 新增 | Pi | 让三家 harness 共享同一套经验入口 |
| 只建索引 | 决策记录、路线历史、lesson | 原文继续留在 Git,记忆库删掉也能重建 |
| 不碰 | baseline、skill、glossary、精确代码事实 | 这些是判断规则或需要精确落点的权威内容 |
Git 仍是规则和被索引文档的权威源,这部分可以重建。原生记忆迁移前必须备份、按项目拆分并核对迁移结果;不能把“文档可重建”扩大为“整库删除没有损失”。派生观察和常驻答案的版本史仍可能丢失。
记忆一致性:新证据来了,旧结论怎么办
开头的旧方案不能只靠“最近的记忆排前面”解决。observations 文档 描述了来源引用、合并与陈旧状态:新材料尚未合并时,派生观察可能过时;冲突应保留变化轨迹,而不是悄悄覆盖过去。
我准备把三条约束带到接入层:派生内容要有来源和引句;源材料更新后检查派生内容是否陈旧;源被删除后,依赖它的内容要重算或删除。重要判断仍回原文核对。因为不采用 reflect 做决策,也不能把它处理陈旧内容的行为,视为普通 recall 注入已经自动具备的保障。
记忆的 recency 降权只影响排序,不等于删除,也不能当成 TTL 或自动遗忘。开头的案例应召回“旧结论为何被推翻”,而不只是把旧方案换个排名。
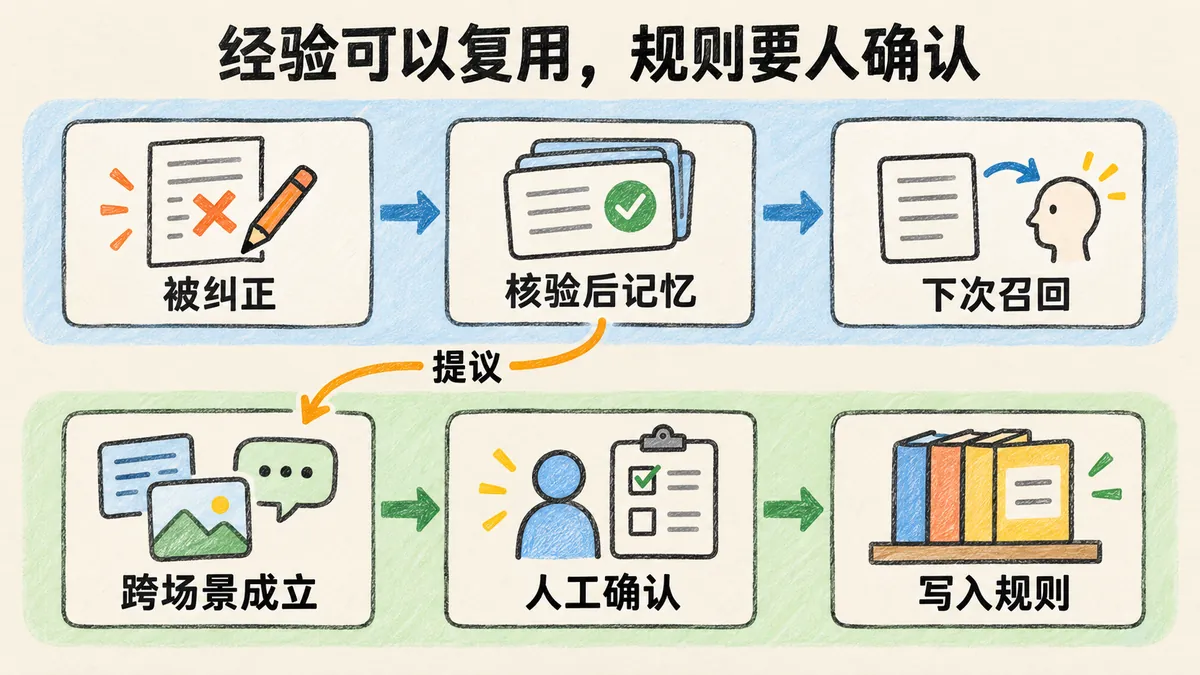
经验变成规则还有另一道门:同一经验在至少两个不相干场景中成立,才提出规则修改建议,经我确认后写入 Git 中的 baseline 或 skill。记忆库不能自行完成这次升级。
部署边界:服务可以远程访问,数据库不要出网
计划把服务放在一台常开的小主机上,通过 Tailscale 组成的私有网络访问。远程只开放运维 SSH 和 hindsight API;Postgres 与向量检索扩展 pgvector 只绑定本机回环地址。控制台默认不开,需要时也只绑定私有网络地址。
1
2
3
其他设备 ── Tailscale ──▶ hindsight API
                              │
                              └──▶ 127.0.0.1:5432 Postgres + pgvector
API 使用独立 key 鉴权,密钥从系统 Keychain 读取后注入启动环境,不落文件,也不出现在命令行参数里。阶段 0 的第一条验证就是:无 key 请求必须被拒绝,有 key 才能通过;鉴权不成立,后续灌库全部停止。
中文检索仍有两个待验证点:embedding 模型不能直接沿用只面向英文的默认值,BM25 的中文分词能力也要实测。它们属于实验问题,不能在文章里提前写成结论。
自托管也不等于所有内容都留在本机:当前设计计划使用 DeepSeek API 做 LLM 加工,送入抽取的材料会经过外部模型服务。写前脱敏适用于个人 bank,团队 wiki 的处理范围还需另行确认。
四个阶段,每阶段都有退出条件
不直接把服务接进所有会话,而是分四阶段推进:
- 阶段 0:离线实验。 只建个人 bank,导入决策、历史和经验记录,用 30 道题对比 hindsight recall 与 grep 对照组。记录正确率、引用正确率、拒答率、token、耗时和 retain 成本。
- 阶段 1:只读注入。 先只接 Claude Code,在用户提交问题的
UserPromptSubmit事件召回并注入上下文。记录条数、token 和最低分;观察两周,额外 token 可接受且没有错误召回,再考虑下一阶段。成本上限仍需明确。 - 阶段 2:受控写入。 质量闸门只放行已验证事实,接入三家 harness;备份与迁移核对通过后,再关闭原生记忆入口。用接入前后四周的纠正计数比较“同一件事被纠正至少两次”的次数。
- 阶段 3:团队知识 bank。 新建团队 bank,只灌 wiki 产物,不灌原始代码;成员分别使用 token,用实测证明两个 bank 互相不可见。材料送交外部 LLM 抽取的范围,必须在导入前确认。
阶段 0 的候选过线标准是:正确率比 grep 高至少 15 个百分点,或者正确率持平且 token、耗时都降到三分之一以内。阈值尚待确认,实验之后依据报告决定 go / no-go,不能写成既定指标或已达效果。
这里比较的是主模型最终回答,不只看召回有没有命中。应拒答题如何判分、引用正确如何核验,还需要在审核题卷时写清,不能看到结果后再改口径。
阶段 0 操作速查与后续回填格式
- 我先确认部署主机已连通,OrbStack 与 Docker Compose 可用;本人在 Keychain 设置服务所需密钥。
- 起 Postgres 与 API,限制监听地址及 Tailscale ACL。验证无 key 被拒、有 key 通过;失败就停在这里修配置,不导入材料。
- 创建个人 bank,导入有来源的决策、历史和经验,记录 retain 总 token 与花费。候选多语言 embedding 和中文关键词检索一起实测。
- 我审核同一份 30 题卷:当前结论 10 题、理由与出处 10 题、应拒答 5 题、时间顺序 5 题。A 组把 recall 交给主模型;B 组让同一模型在同批文件中 grep。提示框架保持一致,逐题记录答案与引用。
- 写报告、决定 go / no-go。后续每阶段追加日期、实际动作、证据链接、结果、学到什么和下一步;没通过就记录差距与回退,不提前填写成功结论。
部署计划使用独立 PostgreSQL,而不是把内嵌数据库当成正式运行方案;备份计划是每日 pg_dump,本地保留 7 份。它们目前也没有执行验证。
失败时怎么退
这套设计把失败路径写在接入之前:
- 召回服务不可达:跳过注入,继续执行当前任务;
- 写入失败:只记账,不自动重试;
- 分数低于阈值:返回空,不把弱相关内容塞进上下文;
- 实验不达标:删除部署和 volume,从 Git 原文重建;
- 阶段 1 中止:摘掉召回逻辑;阶段 2 中止:从迁移前备份恢复原生记忆;阶段 3 中止:移除团队 bank。清理前核对备份与可重建来源。
接入前仍待确认的选择
接入方式尚未最终确定:推荐自写切面逻辑,另一选项是官方包关闭 retainSessions、只保留召回。禁止整段对话自动入库的边界不变。阶段 0 是否先在笔记本验证、过线阈值采用多少,以及阶段 3 的外部模型处理范围,也要分别确认。
这套方案最后要验证的,不是“记忆库能不能回答问题”,而是它是否让经验复用更可靠,同时没有扩大错误的传播面。公共记忆的边界越清楚,Agent 才越可能越用越好。
参考资料
- hindsight 源码:项目定位与自托管入口。
- Observations:派生观察、来源与一致性机制。
- Retrieval:召回与排序机制。
- Recall API:召回参数及最低分约束。
- Reflect:基于记忆生成答案的能力;本文不用于决策。
- Mental models:常驻问题的答案及维护机制,是否需要消费者仍待观察。