Prompt 不只是文本:先划清配置系统的边界
从一个配置表逐渐失控的设计场景出发,判断 Prompt 系统应该管理什么,以及为什么不能接管业务上下文。
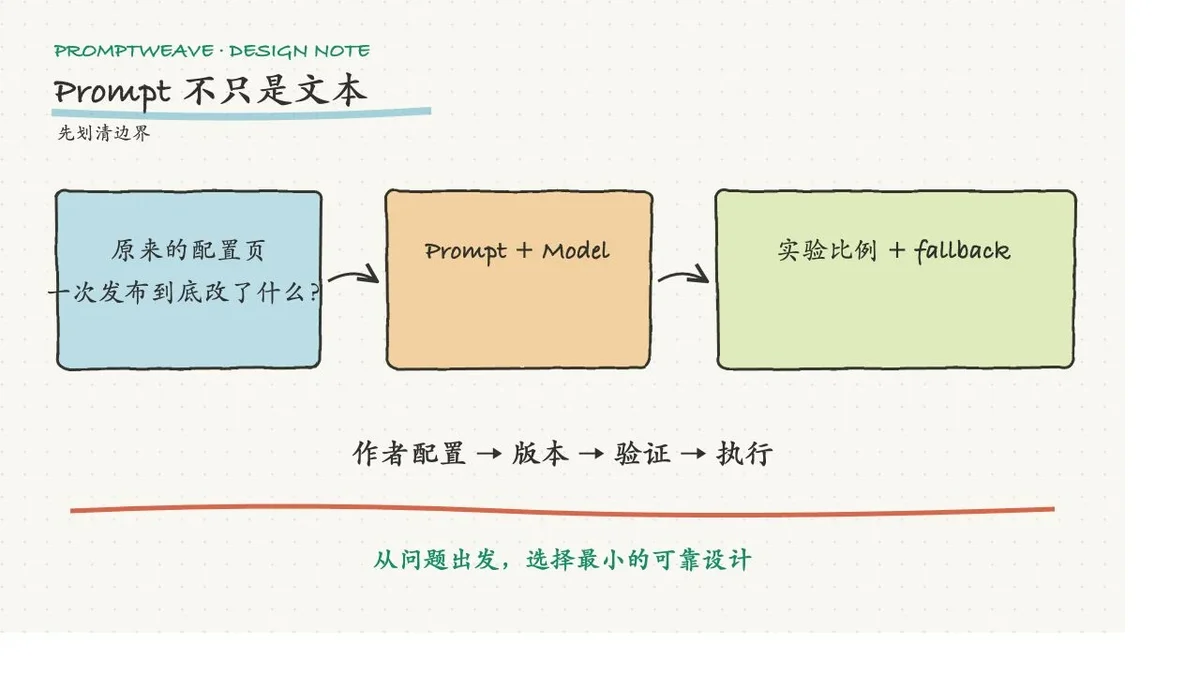
这是 PromptWeave 系列第 1 篇。我们先不讨论数据库表和页面,而是回答一个更基础的问题:Prompt 系统到底要管理什么?
本系列讨论 PromptWeave 的架构设计和实现边界,不代表这些能力已经在生产环境上线。下面是一个设计场景,用来推演边界,也不代表已经发生的生产事故。
一个解题产品最初只有一个配置页面。业务传入 promptCode,系统读取 Prompt 文本和模型配置,然后发起请求。后来团队开始做三件事:给同一个 Prompt 换模型、让两套 Prompt 做 A/B 实验、主模型失败时切换备用方案。
每件事单独看都只是增加一个字段:模型名、流量比例、backup ID。问题在于,这些字段一起改变了请求的行为,却没有一个对象说明“这次发布到底包含什么”。
于是会出现几个问题:
- Prompt 改了,模型是否也要重新验证?
- backup 按名称查找,还是绑定一个确定版本?
- 测试环境里的规则,生产是否加载了同一份?
- 出问题时,只恢复 Prompt 能不能恢复原来的行为?
- 一次请求结束后,能不能还原它实际用了什么?
贯穿整个系列的具体错误是:测试环境验证了“B Prompt + Model B + B backup + 实验规则”,生产发布时却只把 Prompt 切成 B。结果生产仍可能使用旧的 Model A 和旧 fallback;页面看起来已经切换,实际运行的却不是测试通过的组合。
如果只能靠发布人的记忆回答,系统就还没有真正的版本边界。
先分清:作者配置和业务上下文不是一回事
PromptWeave 应该拥有 Prompt 的版本、模型调用方式、受限路由、输入校验和执行记录;它不应该替业务服务拼装完整业务对象,也不应该为了补齐上下文去查询业务数据库。
| 参与者 | 负责什么 | 不负责什么 |
|---|---|---|
| 调用方 | 提交变量、图片等输入,以及已归一化的路由事实 | 把完整业务对象交给配置系统 |
| PromptWeave | 管理 Prompt 版本、模型配置、规则、执行与审计 | 查询业务库、评判业务答案 |
| LLM 网关 | 处理 Provider 传输、凭据和上游重试 | 决定 Prompt 实验和发布 |
| 评测器 | 在后续阶段运行数据集、生成比较证据 | 直接把结果发布到生产 |
这个边界解决的是责任混乱:调用方知道自己要提交什么,PromptWeave 知道自己能改变什么,网关和评测器也不会绕过发布链路。
Prompt 需要自己的生命周期
Prompt 不应该只有“当前内容”一个状态。至少需要经历:
1
2
3
4
5
6
作者编辑
  → 保存版本
  → 校验输入声明
  → 在模型上执行
  → 记录结果
  → 进入测试发布
发布后的版本不能原地编辑。作者可以继续改草稿,但已经被测试或生产引用的 revision 必须保持不变。否则一次历史执行无法重新解释,回滚也只能重新拼出近似配置。
这也是 Prompt 和普通文本模板的差别:Prompt 的内容会影响模型输入,但模型、协议、通道和备用路径同样会影响运行结果。只保存文本,不足以保存一次调用的行为。
第一阶段应该做到什么
第一阶段先做一条窄闭环:
1
2
3
4
5
6
7
PromptAsset
  → immutable revision
  → ModelConfig
  → typed route
  → ExecutionPlan
  → main / fallback
  → release snapshot
这里的 PromptAsset 是作者编辑的 Prompt 和输入声明;ModelConfig 描述通过哪个服务和模型发送请求;ExecutionPlan 把主调用和备用调用绑定起来;release snapshot 保存一次可以被测试、审批、加载和回滚的完整版本。
第一阶段不做自动健康路由、任意规则表达式或自动晋级。先把“同一个版本能被解释、执行和恢复”证明清楚。
下一篇会继续回答:如果 Prompt、模型和路由分别由不同配置负责,一次请求到底由谁决定使用哪一套?