Prompt caching:为什么只改一个 token,后面就不能复用?
从带前文的 KV 状态理解提示缓存,用一台交互式前缀校验机观察命中边界,再区分 OpenAI 与 Anthropic 的断点、TTL 和计费规则。
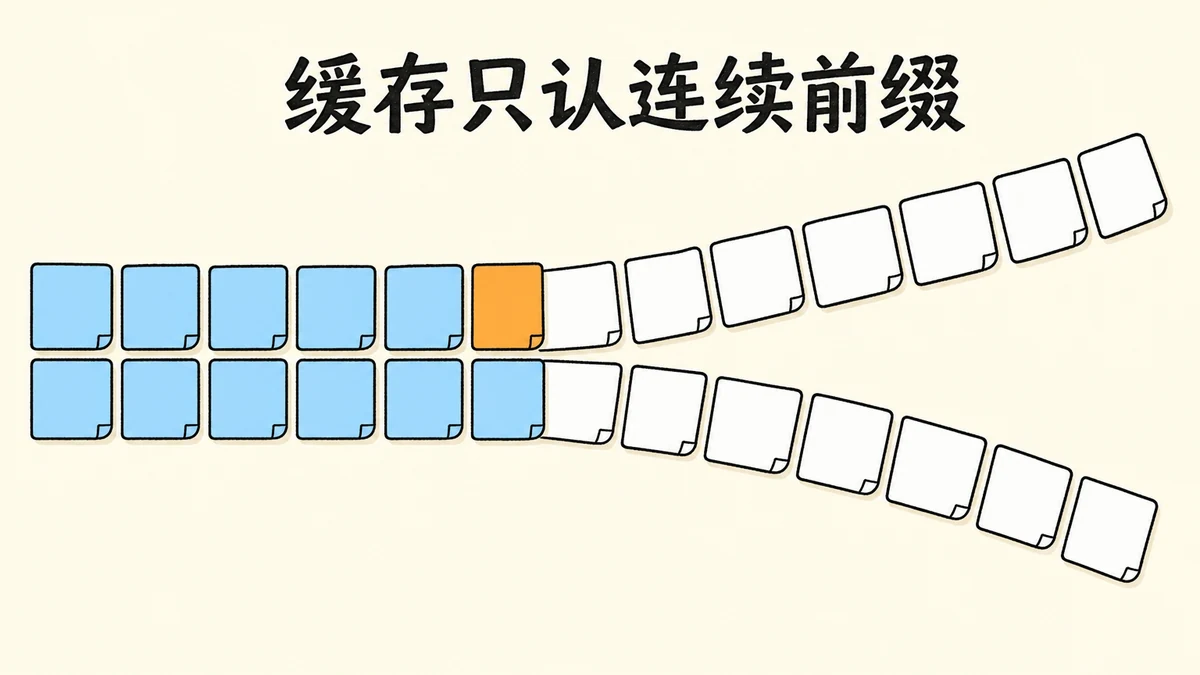
假设你在做一个代码审查 Agent。每次请求都带同一套工具定义、审查规则和项目说明,只在最后换一段待审代码。公共材料很长,你希望它们能命中 prompt caching(提示缓存)。
后来,你在系统提示开头加了一行“当前时间”,方便模型理解任务背景。后面的规则和项目说明一个字没改,缓存命中却明显减少。直觉上,这只是改了很小的一段;为什么缓存不能跳过它,继续复用后面那一大段?
提示缓存复用的是带着前文计算出的状态。第一处 token 差异会切断旧前缀的后续复用;稳定内容应放前,易变内容应放后,同时满足厂商的缓存边界与存活条件。
这里的“不能复用”,指这次请求不能沿用那条旧前缀的后续缓存,并不意味着服务端删除了旧缓存。如果另一条请求仍带原来的前缀,它仍可能命中。
缓存记住的不是一段独立文字
先区分两种容易混淆的东西:把“问题 → 答案”存起来,下次直接返回,是答案缓存;prompt caching 保存的是模型处理输入时得到的中间状态。命中后,模型仍要处理新增输入、生成这次的回答。
OpenAI 官方文档把这些中间状态称为 key-value(KV)状态:后续计算可以通过它们参考前面的 token。这些状态不是一份可以任意剪贴的文字段落。
为什么前文会影响后文?可以先抓住一个方向:后面的位置能参考前面的位置,前面的位置不能反过来读未来。这是通常的自回归 Transformer 使用的因果约束,见原始论文 Attention Is All You Need。随着网络逐层计算,某个位置的状态会带上前文的信息,不能只凭这个位置的文字相同,就认定原状态仍然适用。
把两个请求写成这样,会更容易看见问题:
1
2
旧请求:A → B → C → D
新请求:A → B′ → C → D
C 的文字虽然没变,前文却从 A, B 换成了 A, B′。旧缓存里的 C 是在旧上下文中算出的结果,不能接在新上下文后面。同理,D 也不能跳过去复用。
不需要断言“后面每个向量必然都变了”,就能得出这个结论:精确前缀已经不一致,旧状态不能再被当作这次请求的有效计算结果。 而 A 没有读过后面的 B,它仍然保有复用的可能。
不过,“前面不受影响”还只是内容条件。还要认识缓存断点(breakpoint):它标记一条前缀在哪个位置结束,服务可以保存或查找截至这里的状态。真实服务要在允许的边界上找到已经写入、尚未失效的缓存,实际命中长度可能比相同的文字前缀更短。
先猜一下,再拨动机器
先选一个答案,不必急着展开。
- 只修改 Anthropic 顶层系统提示的末尾,前面的工具定义还能命中吗? 假设工具定义相同、工具末尾已有有效缓存,长度合格,本次也会查询该边界。
- 只改参考资料中的一个 token,资料后面完全相同的当前问题,能单独复用旧缓存吗? 假设没有另一条匹配新前缀的缓存。
看完图再展开:第一题
可以。 Anthropic 明确规定缓存前缀按 tools → system → messages 组织,修改系统提示不会倒过来改写工具前缀。题目已经补齐了缓存存在、长度和查询边界条件;若没有这些条件,就只能说工具前缀仍有复用资格,不能保证命中。
依据:Anthropic 的提示结构与失效规则,查证于 2026-10-12。这里说的是厂商组织后的上下文顺序,不是你在请求 JSON 中排列字段的顺序。
看完图再展开:第二题
不能。 当前问题的文字相同,但它前面的资料变了,所以不再是同一条完整前缀。缓存不能把旧资料之后的状态当成独立片段接回来。需要从可命中的旧边界之后处理输入,再生成新回答。

这台机器把输入排成连续的分段带。选择一段,相当于改动那一段的首个 token;边界前是可复用的前缀,边界后都需要重新处理。先改参考资料,再把改动移到系统指令或工具定义,观察“没有修改的后半段”为什么也跟着失去复用。
图使用确定性 SVG(anatomy skill)绘制。每段等长只是为了看清关系,不代表厂商按这样的长度切块;模型假设各段末尾都已有有效缓存,且本次查询能找到它们。它隔离的是“改动位置”的影响,不是在模拟某个 API 的完整缓存调度。
图旁的成本只算本次缓存读取与普通输入处理,不含预热、新写入和输出费用。
交互图的成本口径与真实账单
图中的相对成本,以“相同长度输入全部按普通输入价处理”为基准,只算本次缓存读取与未缓存输入处理。设命中量为 H、需要重算的量为 R、缓存读取价格相对普通输入价格的倍率为 r:
1
相对输入成本 = (H × r + R) / (H + R)
演示取 r = 0.1,对应 Claude Sonnet 4.6 的缓存读取倍率;依据是 Anthropic 官方价格表,查证于 2026-10-12。这不是所有模型统一的折扣。
图没有计入此前预热缓存的费用,也没有模拟为新后缀写缓存,更不包含输出费用。如果实际请求发生缓存写入,就要按对应写入价格重新算账;“重算了多少输入”与“整次调用付了多少钱”不是同一个量。
仍以 Claude Sonnet 4.6 为例,5 分钟缓存写入为普通输入价的 1.25 倍,1 小时写入为 2 倍;来源同上,查证于 2026-10-12。实际账单将读取、写入、普通输入分别乘对应价格,再加输出费用。
相同前缀,为什么有时仍然不命中
回到代码审查 Agent。把时间戳移到最后,能保住前面内容不变,但不能凭这一点就宣布修好了缓存。
给整份请求末尾设置断点,不代表服务自动在所有中间位置都存了一份。
例如,首次请求只在“规则 + 项目说明 + 待审代码”的末尾写入缓存。下次待审代码变了,公共规则虽然没变,却可能根本没有一条“截至公共规则末尾”的旧缓存可读。把断点放到稳定内容的末尾,需要先通过一次请求把这条前缀真正写进去。
稳定前缀决定哪里有机会复用;已经写入、可被查到且仍然存活的缓存边界,才决定这次真正命中了哪里。
OpenAI 与 Anthropic 的文档都描述了这类“稳定内容存在,但没有对应旧写入”的未命中。两家的控制方式却不能混用:
| 你需要核对什么 | OpenAI | Anthropic Claude API |
|---|---|---|
| 匹配的对象 | 完整渲染后的前缀,包括平台指令、工具定义、开发者消息和历史;相关请求设置也可能改变它 | 累积前缀,按 tools → system → messages 组织;断点覆盖之前的全部内容 |
| 如何选择边界 | GPT-5.6 及之后支持隐式与显式断点,相关字段为 prompt_cache_options.mode、prompt_cache_breakpoint;更早模型只支持隐式缓存,规则不同 | 用 cache_control 标记内容块;也支持请求级自动缓存,但自动边界不一定恰好落在你的稳定内容末尾 |
| 什么会被查找 | 在本次请求允许的查询边界中,寻找最长的可用匹配;不能假设任意 token 位置都有缓存 | 从断点向前检查内容块边界,寻找之前请求已经写过的前缀;回溯有范围限制 |
| 最小长度 | GPT-5.6 及之后为 1,024 个可见输入 token;更早模型依请求设置而异 | 依模型而异;例如 Claude Sonnet 4.6 为 1,024 token,不能推广到所有 Claude 模型 |
| 存活时间 | GPT-5.6 及之后当前支持 ttl: "30m",最近写入或复用后至少 30 分钟;旧模型另有 retention 规则 | 默认 5 分钟,命中会刷新;可选 1 小时,写入价格不同 |
表中规则与数字查证于 2026-10-12:OpenAI 缓存指南及模型差异表;Anthropic 最小长度与缓存时长。模型名中的版本号用于限定适用范围。
因此,看到一篇旧教程写“OpenAI 完全自动,无需断点”“Claude 缓存一律同一个起步长度”,不要直接当作今天所有模型的规则。先固定你实际调用的模型与平台,再核对文档。
把这个判断用回 Agent 请求
对开头的代码审查 Agent,我会先调整同一角色内部的内容顺序与消息组织,不为缓存改变指令优先级:
1
2
3
4
5
工具定义:名称、描述、schema 与顺序保持稳定
系统 / 开发者指令:稳定的审查规则
消息中的公共材料:相对稳定的项目说明
──── 在合适的稳定末尾设置缓存边界 ────
消息中的本次材料:当前时间、待审代码、这一轮的问题
这是一份组织示意,不是跨厂商通用的请求 JSON。工具、系统指令与普通消息各有协议位置;不能把原本有高优先级约束作用的系统规则降为用户消息,只为得到更长的缓存。
落到已有调用链,可以按下面的顺序改:
- 找到第一处真实差异。 对比两次请求中工具定义、系统或开发者指令、历史消息及相关设置。时间戳、随机标识、工具排序变化都可能出现在当前问题之前;别只比较最后一条消息。不要把含秘密的请求全文写进调试日志。
- 让稳定内容形成连续前缀。 把每次变化的任务材料放到合适的后部消息中。Agent 继续执行时,未修改的历史可以作为前缀,后接新消息;需要摘要、压缩或裁剪时照常进行,把重写后的历史视为新前缀重新验收缓存。不为命中率无限保留历史。
- 在稳定末尾建立可读的缓存。 按当前模型的机制设置边界、检查最小长度,并先完成一次缓存写入。不要为了凑长度塞无用文本;先确认这些公共材料本来就值得带入上下文。
- 从响应核对结果。 分别测试原样重发、只改尾部、改前部,读缓存用量字段。期望是尾部变化仍能复用稳定前缀,前部变化降低对应命中量;单次延迟变快不能独立证明缓存命中。
缓存未命中不等于请求失败:正常路径是重新处理输入并生成回答。
排查速查:读哪些字段,没命中时先查哪里
| 接口 | 缓存读取量 | 还要区分什么 |
|---|---|---|
| OpenAI Responses API | usage.input_tokens_details.cached_tokens | 支持写入计费的模型还可查看 usage.input_tokens_details.cache_write_tokens;不要把所有输入都当成普通输入价 |
| Anthropic Messages API | usage.cache_read_input_tokens | cache_creation_input_tokens 是写入量,input_tokens 是既未读缓存、也未写缓存的输入量 |
Anthropic 的总输入量为 input_tokens + cache_creation_input_tokens + cache_read_input_tokens,不能直接把其中的 input_tokens 当作总量。
字段依据:OpenAI 缓存指南与Anthropic 用量解释,查证于 2026-10-12。
若原样重发仍没命中,先核对缓存是否真正写入、是否达到该模型最小长度、是否仍存活,以及本次是否查询原来的边界。再检查模型、请求设置和厂商的路由或隔离条件。prompt_cache_key 不能强行让不同前缀变成同一个缓存。
新增模板或工具定义后,允许首批请求建立新缓存;若改动导致持续未命中,定位最早变化点,修正请求组织或边界,再重复上述对照。不要为了恢复命中而回退必要的安全规则。
这个比喻在哪里不成立
机器解释的是依赖方向,不是服务器内部的真实机械结构。用它推理时,至少要保留这些边界:
| 机器里的部件 | 真实机制 | 哪里不一样 |
|---|---|---|
| 等长分段带 | 服务按支持的内容块、消息末尾或模型特定边界读写缓存 | token 是模型的编码单位,不等于一个字;图中的等长段是教学划分,不能据此推算某个 token 修改后的精确命中数 |
| 每段末尾都能停住的游标 | 只能复用已经写入、且本次能查到的边界 | 真实请求未必在所有稳定位置都有旧缓存,命中量可能更短,甚至没有命中 |
| 永久摆在桌上的旧记录 | 缓存有存活时间与可用性条件 | 文字完全相同也可能因过期等原因重算;OpenAI 还明确说明匹配缓存所在机器的路由会影响命中 |
| 只改某段首个 token 的按钮 | 真正的编辑会经过 tokenization,工具或设置还可能改变渲染后的上下文 | 改一个字符不保证只改一个 token;应用看到的文本 diff 不一定就是最终前缀差异 |
| 单一成本表 | 读取、写入、普通输入和输出分别计费,模型倍率不同 | 图省略了预热、新写入与输出费用,不能把输入读数当作整次调用费用;具体计费见前面的成本口径 |
表中的服务边界来自上文两家的官方缓存指南,计费区别见 Anthropic 官方价格表;均查证于 2026-10-12。原始 Transformer 论文支持因果依赖的解释,不代表这两家公开了全部内部实现。
回到那个时间戳:问题不在于改动很大,而在于它出现得太早。下次命中量下降时,先定位第一处差异之前,还剩下哪条真正可读的缓存前缀,比统计“整份提示有多少文字没变”更有用。
参考资料
- OpenAI:Prompt caching——KV 状态、完整前缀匹配、模型代际差异、查询边界与存活时间。
- Anthropic:Prompt caching——累积前缀、内容块断点、失效层级、模型长度门槛、用量字段与价格。
- Attention Is All You Need——decoder 的因果遮罩与注意力机制;用于解释前后文依赖方向。